Le Coach Transport
Une application mobile pour préparer l'examen d'attestation de capacité en transport de marchandises : fiches, quiz, études de cas, examens blancs et suivi de progression. Conçue, développée et publiée sur l'App Store et Google Play.
Outils et technologies
- TypeScript
- React Native
- Expo
- Redis
- BullMQ
- Docker
- Sentry
- React
- Fastify
- PostgreSQL
- Stripe
- RevenueCat
- API OpenAI
Le problème n'était pas celui que je croyais
Au départ, je voyais un problème d'entraînement : des questions, des fiches, des statistiques. Du classique.
Sauf que l'examen de l'attestation de capacité n'est pas un examen classique. Il se tient une fois par an. Il impose trois conditions en même temps : au moins 50 sur 100 au questionnaire à choix multiples, au moins 40 sur 100 à l'épreuve rédigée, et au moins 120 sur 200 au total. Chacune est éliminatoire. Le taux de réussite tourne autour de 30 %.
En face, le candidat type est en reconversion. Il révise seul, le soir, après sa journée. S'il rate, il ne recommence pas le mois suivant : il attend un an.
Et c'est là que la question change de nature. À partir du moment où une application affiche une progression, elle répond déjà à « est-ce que je suis prêt ? ». Qu'on l'ait voulu ou non. Autant y répondre exprès, et bien.
Ce qui rend l'exercice tordu : aucun retour, jamais
Normalement, un indicateur prédictif se calibre sur des résultats : on prédit, on compare, on ajuste. C'est la base.
Ici, cette boucle n'existe pas. Au moment où j'affiche un chiffre à quelqu'un, je n'ai aucun résultat réel pour le vérifier. Et je n'en aurai pas avant octobre — puis une fois par an, pour la fraction des utilisateurs qui voudront bien me dire s'ils ont réussi.
Autrement dit : soit j'attends d'avoir des données pour être prudente, soit je suis prudente tout de suite. Attendre, ça voulait dire publier plusieurs saisons d'estimations non vérifiées à des gens qui jouent une année de leur vie dessus. Ce n'était pas une option.
Donc la contrainte s'est transformée en décision de conception : si la calibration ne peut pas venir des données, elle doit venir de la construction. Chaque formule devait porter sa propre marge de prudence, et je devais être capable de justifier chacune sans la moindre observation.
Les deux erreurs ne se valent pas
Un indicateur de préparation peut se tromper dans deux sens. On s'arrête souvent au constat qu'aucun des deux n'est souhaitable. Je trouve que c'est passer à côté de l'essentiel : les deux erreurs n'ont pas du tout le même coût.
Trop optimiste, je fais lever le pied à quelqu'un qui aurait dû continuer. Il se présente, il échoue — et mon application a produit exactement ce qu'elle prétendait éviter. Pire : personne ne s'en rend compte avant le jour des résultats, quand plus rien n'est rattrapable avant un an.
Trop prudent, je démotive. C'est un vrai coût, je ne le minimise pas. Mais l'erreur est visible tout de suite, et récupérable : le candidat continue de travailler, l'indicateur monte, la trajectoire se corrige toute seule.
Le déséquilibre est net, et il est durable. À partir de là, la décision s'écrit seule : le biais va vers la prudence, il est assumé, et il est dans les formules — pas dans une mention en bas d'écran.
Trois indicateurs, pas un score unique
La solution facile, c'était un « niveau » unique. C'est ce que font la plupart des applications de révision, et c'est précisément ce qui ne pouvait pas marcher ici : un seul chiffre aurait dû répondre à trois questions qui n'ont rien à voir.
J'ai donc séparé.
Un classement de force, par thème. Un ELO, comme aux échecs, tenu par candidat et par thème — et symétriquement par question, parce que la question est traitée comme un adversaire. Une question systématiquement ratée gagne des points, exactement comme un joueur qui gagne ses parties. Départ à 1200, bornes entre 600 et 2400, et un coefficient d'ajustement deux fois plus élevé côté candidat que côté question : un profil doit bouger vite, une banque de questions doit bouger lentement et ne pas se faire démolir par une poignée de candidats atypiques.
Cet indicateur ne s'affiche jamais. Il sert uniquement à choisir la question suivante. Un indicateur interne n'a pas à devenir un score de vanité, et l'afficher n'aurait fait qu'ajouter une échelle de plus à interpréter.
Un indice global de progression, de 0 à 100. La lecture pédagogique. Il agrège quatre choses : la réussite pondérée par la difficulté sur les deux cents dernières réponses, la régularité (l'écart entre les cinq dernières tentatives, converti en score), la part de questions réellement consolidées parmi celles déjà vues, et la performance en examen blanc.
Un indice de probabilité de réussite à l'examen. La projection, celle qui répond à « suis-je prêt ? ». Construite uniquement sur des examens blancs complets.
Et l'écart entre les deux derniers est devenu un signal à part entière : l'application affiche un message dédié quand un indice de progression élevé cohabite avec une probabilité faible, et inversement. C'est exactement la situation où un score unique aurait menti.
Comment on écrit de la prudence dans du code
On prend le maillon faible, pas la moyenne
L'examen ne se gagne pas sur une moyenne : il impose trois conditions simultanées. La probabilité affichée est donc le minimum des trois probabilités partielles — questionnaire, rédigé, total — et surtout pas leur moyenne. Un excellent questionnaire ne doit jamais masquer un rédigé faible, puisque le jour J, il ne le masque pas.
On s'interdit la certitude
Chaque probabilité partielle est convertie depuis le score moyen par une fonction linéaire par morceaux. Choix délibéré : je voulais quelque chose de lisible et testable, pas un ajustement statistique opaque que je n'aurais pas su défendre sans données. Et aucune ne dépasse 95, 97 ou 98 selon l'épreuve. Le calcul ne peut structurellement pas annoncer une réussite certaine.
On regarde le pire résultat, pas seulement la moyenne
Une moyenne correcte obtenue avec un accident de parcours n'est pas une moyenne correcte. Quand le plus mauvais résultat de la série passe sous les seuils éliminatoires, une décote s'applique, jusqu'à vingt points de probabilité. S'y ajoute une pénalité d'irrégularité au-delà d'un certain écart entre les tentatives, et, dans l'autre sens, un bonus de progression — plafonné à dix points, parce qu'une bonne dynamique reste une promesse, pas un résultat.
On refuse de projeter quand la preuve manque
C'est là que se joue la vraie décision. Sans aucun examen blanc, la projection est bornée à la moitié de l'indice de progression, et à 50 au maximum. Impossible d'afficher une belle probabilité à quelqu'un qui n'a jamais tenu quatre heures d'épreuve. Avec un seul examen blanc, le résultat est multiplié par 0,85 — un facteur de prudence explicite, nommé comme tel dans le code. À partir de deux, le calcul s'applique normalement.
On ne se déclare pas prêt sans l'avoir prouvé
L'indice de progression se traduit en quatre paliers, mais le palier affiché n'est pas la simple lecture du score. En dessous de six tentatives terminées, ou avec un taux d'achèvement sous 65 %, le palier est plafonné à « Intermédiaire ». En dessous de deux examens blancs, il est plafonné à « Avancé ». Traduction : on ne devient pas « prêt pour l'examen » en ayant réussi trois quiz de dix questions et abandonné tout le reste.
Et on évite quand même de décourager
Parce qu'il y a une limite à tout ça, et elle compte : la prudence porte sur la promesse, jamais sur le candidat.
Un utilisateur qui démarre est à 50, pas à 0. Le score de consolidation se calcule sur les questions déjà vues, jamais sur la banque entière — un débutant n'a pas à être puni d'avoir peu pratiqué. Et quand un examen blanc manque, son poids est redistribué sur les autres critères au lieu d'être compté comme un zéro.
Enfin, l'incertitude est affichée au lieu d'être planquée : le nombre d'examens blancs passés apparaît comme un niveau de confiance — faible, moyenne, élevée — avec la consigne qui va avec. Dire « cette projection n'est pas encore fiable, voilà comment la fiabiliser » est infiniment plus utile qu'un chiffre bien net et faux.
Et l'IA dans tout ça ?
J'ai déjà écrit ailleurs que l'IA est un outil, pas une stratégie. Ce produit est probablement l'endroit où je l'ai appliqué le plus strictement.
Sur Le Coach Transport, la décision structurante a été une décision de non-usage. Le modèle ne génère aucune question, ne calcule aucun indicateur, ne corrige aucun questionnaire à choix multiples. Les réponses exactes et les listes sont traitées par des règles déterministes : normalisation, extraction de valeur et d'unité avec tolérance, correspondance par fragments avec pénalité pour les éléments hors sujet. Un algorithme bien conçu fait le travail, et il le fait de façon reproductible.
Le modèle intervient sur un seul point : évaluer une réponse rédigée à une étude de cas. Et seulement quand la note compte, c'est-à-dire en examen blanc. En mode entraînement, le candidat s'auto-évalue face à une grille de critères explicite, sans aucun appel au modèle. Relire sa propre copie contre des critères visibles a une vraie valeur pédagogique — que la correction automatique n'a pas — et ça ne coûte rien.
Là où le modèle intervient, il est traité comme un contrat, pas comme une conversation. Version du prompt épinglée et enregistrée avec chaque correction, au même titre que la version de la grille : deux copies corrigées par deux versions différentes restent distinguables. Sortie strictement contrainte, température basse, codes de raison énumérés, consigne de n'évaluer que le texte fourni et de ne jamais inventer ce qui n'y est pas.
Et trois modes de panne traités séparément, ce qui est la même idée appliquée ailleurs. Une copie blanche court-circuite l'appel : score nul, retour pédagogique, aucun risque d'invention sur du vide. Sans clé d'accès, la correction est marquée indisponible et aucun modèle n'est inscrit dans les métadonnées — je ne vais pas faire croire qu'une correction a eu lieu. En cas de panne, des réessais espacés, puis un score nul assumé et un message annonçant qu'un formateur pourra reprendre la copie. Dans tous les cas, la chaîne va au bout : recalcul du score, des indicateurs, notification.
Tout est tracé, sinon rien n'est défendable
Chaque série de questions générée écrit sa propre trace : type de génération, réglages utilisés, répartition obtenue. Chaque calcul de probabilité enregistre ses variables intermédiaires — moyennes, minimums, écart-type, probabilités partielles, pénalités appliquées.
Concrètement, je peux rejouer pourquoi telle série a été servie à telle personne six mois plus tôt, et expliquer un score contesté ligne par ligne.
C'est ce qui fait la différence entre une note et une boîte noire. Si un candidat conteste son résultat, je peux le reconstituer et le lui expliquer, au lieu de lui répondre que c'est l'algorithme.
Deux détails qui ont changé le produit
Le tri trop bien fait. Classer les questions strictement par pertinence produit un ordre total : à état d'apprentissage constant, l'application resservait exactement la même série. Correction : regrouper les questions par tranches de cinquante points de classement, ordonner les tranches, et mélanger à l'intérieur de chaque tranche. Le bon niveau est conservé, la prévisibilité disparaît.
Le mélange qui n'en était pas un. Trier au hasard avec un comparateur qui renvoie une valeur aléatoire ne produit pas une permutation uniforme. Sur un tirage de questions, ça se voit. Remplacé par un mélange de Fisher-Yates.
Deux détails, vraiment. Mais le premier rendait l'application ennuyeuse et le second faussait le tirage.
J'y ajoute une règle que je ne négocie pas : une annale est servie telle quelle. Pas d'injection d'erreurs, pas de réharmonisation, pas de rééquilibrage. Le moteur adaptatif ne s'applique qu'aux entraînements. Les examens blancs, eux, sont des annales : le référentiel officiel reste stable et reproductible.
Ce que j'en retiens
Précision honnête : aucun candidat n'a encore passé l'examen avec cet outil. Ce que je décris ici, c'est un raisonnement de conception, pas une efficacité démontrée. C'est d'ailleurs cohérent avec ce que je refuse de promettre — je ne garantirai jamais une réussite qui dépend d'un travail que je ne contrôle pas.
Ce qui se transpose, en revanche, tient en une phrase : nommer l'erreur la plus coûteuse avant de choisir la formule.
Le minimum plutôt que la moyenne, les plafonds, les replis, les paliers bloqués, l'IA cantonnée à une seule tâche : tout découle d'une analyse faite avant la première ligne de code, celle du coût respectif des deux façons de se tromper.
Sans elle, on obtient un score qui a l'air juste. Avec elle, on obtient un score dont on peut défendre chaque borne.
Note — septembre 2026. Ce texte décrit le produit tel qu'il est conçu à ce jour. Les formules, les seuils et les garde-fous qui y sont décrits sont ceux en vigueur au moment où je l'écris : ils évolueront, au fil des retours des utilisateurs et des premiers résultats d'examen, qui ne tomberont qu'après la session du 14 octobre. C'est d'ailleurs cohérent avec tout ce qui précède — un indicateur calibré par construction est fait pour être recalibré dès qu'il y a de quoi le faire.
Projets similaires
Ce portfolio
2026
Portfolio et point d'entrée vers mes projets : réalisations, publications et parcours, administrés depuis un espace dédié.
- Docker
- PostgreSQL
- Umami
- PHP
- Symfony
- PHPUnit
- FrankenPHP
Atelier Praxea
2026
Site d'acquisition de Praxea : une page optimisée par produit, données structurées, FAQ, aperçu du sommaire et maillage interne. Site statique auto-hébergé, sans cookies, où ajouter un produit ne demande qu'un fichier Markdown.
- TypeScript
- React
- Next.js
- Umami
Flottup
2026
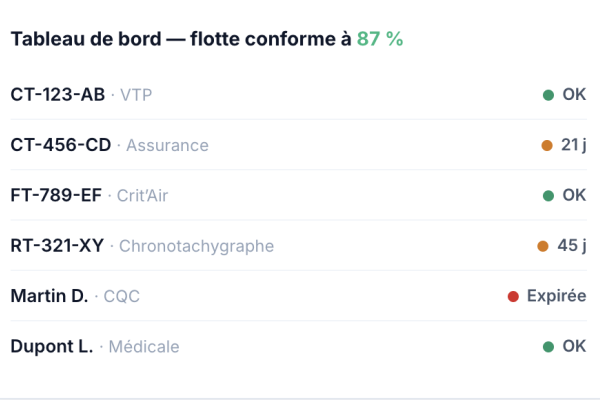
Copilote de conformité pour les TPE et PME du transport routier : échéances des véhicules et des conducteurs, alertes par e-mail et notifications, contrôles avant départ, synthèse de conformité en PDF. Deuxième produit de la suite Routea.
- TypeScript
- Docker
- Sentry
- React
- Fastify
- PostgreSQL
- Stripe
- Next.js
- Web Push